
Lokale KI-Modelle galten lange als Bastelei für Enthusiasten. Doch in 2026 kommt lokale KI schon sehr nahe an aktuelle Modelle: Das offene Modell Qwen3.8-27B erreicht in Blind-Abstimmungen 1438 Punkte und damit das Niveau des Cloud-Flaggschiffs GPT-5 (1435) – und läuft auf einem 32-GB-Mac oder einer Grafikkarte mit 24 GB. Gleichzeitig bleiben die ganz neuen Cloud-Modelle noch 1-2 Schritte voraus, und Speicher ist 2026 historisch teuer.
Die entscheidende Frage lautet deshalb nicht mehr „Geht lokale KI überhaupt?“, sondern: Welches Modell läuft auf deiner Hardware – und wann brauchst du doch die Cloud?
Die kurze Antwort: Dein Speicher entscheidet, nicht das Modell.
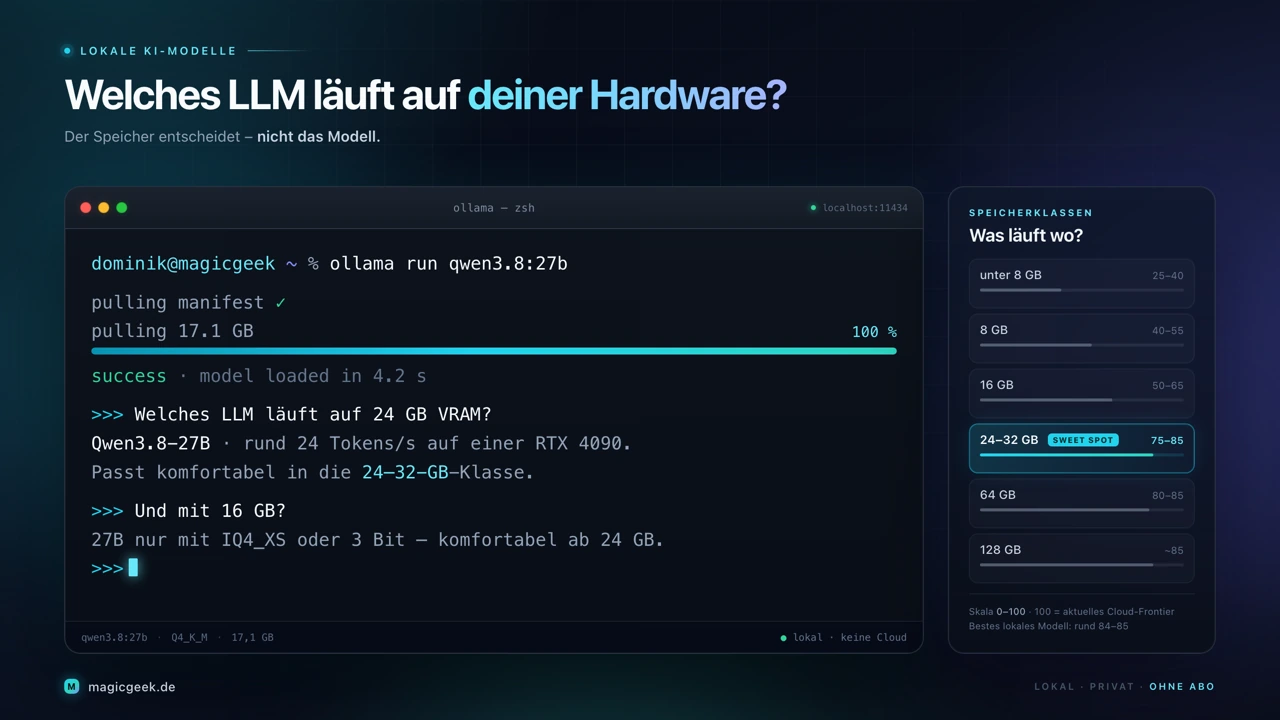
- 24–32 GB Speicher (VRAM oder Unified Memory) sind der Sweet Spot: Hier läuft Qwen3.8-27B in guter Qualität – auf dem Niveau des Vorjahres-Flaggschiffs.
- 8–16 GB reichen für kleine Allrounder bis rund 12B Parameter.
- Unter 8 GB sind Autovervollständigung beim Coden und einfache Helfer wie Home Assistant möglich.
- Aktuelle Open Source Modelle (nahezu GPT-6 Astra, Claude Opus 5 Niveau) braucht 256 GB und mehr – Enthusiasten- und Server-Terrain.
Ein Hinweis vorab: Alle Angaben in diesem Artikel sind eine Momentaufnahme, Stand Ende 2026 (Preise: Oktober 2026). Wie es sich anfühlt, mit lokalen Modellen zu arbeiten, beschreibt der Erfahrungsbericht Vibecoding mit lokaler LLM statt ChatGPT – dort wurden unter anderem Gemma 4 31B und Qwen 3.6 35B-A3B praktisch getestet.
Lokale KI-Modelle: Warum der Speicher entscheidet
Heruntergeladene Modelle sind in der Regel quantisiert, also komprimiert. Standard sind 4 Bit pro Gewicht (Kürzel Q4). Das kostet kaum Qualität: Die verbreitete Variante Q4_K_M erreicht laut Messungen rund 99 Prozent des Vollpräzisions-Niveaus. Erst unterhalb von 4 Bit werden kompakte Modelle spürbar schlechter.
Für die Planung gilt eine Faustformel von 0,5 GB pro Milliarde Parameter. In der Praxis liegen echte 4-Bit-Dateien aber bei 0,54 bis 0,63 GB pro Parameter – und mit Betriebssystem und Kontext landest du bei rund 0,75 GB pro Parameter. Ein 27B-Modell braucht also realistisch 17 bis 20 GB Speicher, nicht 13.
Genau hier liegt der häufigste Denkfehler, der 16-GB-Irrtum: Qwen3.8-27B „sollte“ mit etwa 13,5 GB auf eine 16-GB-Grafikkarte passen. Die echte Datei ist aber 17,1 GB groß. Mit der stärker komprimierten Variante IQ4_XS (15,7 GB) oder 3 Bit geht es gerade so – komfortabel wird es erst ab 24 GB.
Dazu kommt: Der nutzbare Speicher ist kleiner als die Zahl auf der Packung. Auf einem Mac bleiben von 16 GB rund 10,6 GB für das Modell, von 24 GB etwa 16 und von 32 GB rund 21 GB.
Und der Kontext ist die zweite Rechnung: Der KV-Cache wächst mit der Textlänge und kann die Modellgewichte sogar übersteigen. Ein 8B-Modell mit 5,4 GB Gewichten belegt bei 32K Kontext noch einmal gut 5 GB. Wer lange Dokumente verarbeiten will, braucht mehr Speicher als die Dateigröße vermuten lässt.
Welche Art Speicher du hast, bestimmt das Tempo:
- System-RAM (DDR5): 80–100 GB/s, groß und günstig, aber langsam.
- Grafikkarten-VRAM: sehr schnell (RTX 4090 rund 1 TB/s, RTX 5090* rund 1,8 TB/s), aber bei Consumer-Karten auf maximal 32 GB begrenzt.
- Unified Memory (Apple): die goldene Mitte – vom Mac mini M6* (170 GB/s) bis zum M5 Ultra (rund 1,2 TB/s), je nach Modell bis 512 GB.
Bei einem 27B-Modell ergeben Modellrechnungen (Schätzwerte, keine Messwerte) grob: rund 2 Tokens pro Sekunde auf der CPU, etwa 11 auf einem Mac der M5-Klasse, 24 auf einer RTX 4090, 28 auf einem M5 Ultra und rund 42 auf einer RTX 5090*. Kleine 3B-Modelle schaffen dagegen selbst auf einer CPU 15 bis 30 Tokens pro Sekunde.
Ein Sonderfall sind Mixture-of-Experts-Modelle (MoE): Bei ihnen zählt für den Speicher die Gesamtzahl der Parameter, fürs Tempo aber nur der aktive Teil – deshalb tragen sie Namen wie „36B-A4B“ (36 Milliarden Parameter gesamt, 4 Milliarden pro Token aktiv).
Die Hardware-Klassen im Überblick
| Dein VRAM | Das läuft gut (4 Bit) | Grobe Skala |
|---|---|---|
| Unter 8 GB | Kleine Helfer und Spezialisten (2–4B): K2 Horizon 3.7B, Granite 4.2 3B, Gemma 4 E4B, Phi-4-mini | 25–40 |
| 8 GB | Kleine Allrounder bis 7B: K2 Horizon 7B, Granite 4.2 8B (knapp, Q4_K_S), Ministral 3 8B | 40–55 |
| 16 GB | Allrounder bis 12B: Gemma 4 12B, Qwen2.5-Coder-7B | 50–65 |
| 24–32 GB | Der Sweet Spot: Qwen3.8-27B, Gemma 4 31B, Gemma 4 26B-A4B, K2 Horizon 36B-A4B, Devstral Small 2 (Coding), GLM-4.7-Flash | 75–85 |
| 64 GB | Qwen3.8-27B in 8 Bit, gpt-oss-120b, Qwen3-Coder-Next | 80–85 |
| 128 GB | Qwen3.8-Flash-Next (180B-MoE, 94 GB in 4 Bit) | ~85 |
Zur Skala: 100 entspricht einem aktuellen Cloud-Flaggschiff (wie z.B. GPT-6 Astra, Claude Opus 5). Das beste lokale Allrounder-Modell liegt bei rund 84 bis 85 – also etwa auf dem Niveau eines vorherigen Flaggschiffmodells. Zwei ehrliche Einschränkungen: Coding und agentische Aufgaben fallen lokal 5 bis 15 Punkte niedriger aus, und die 4-Bit-Quantisierung kostet ein paar Punkte gegenüber Herstellerwerten, die meist mit voller Präzision gemessen werden. Ein bis zwei Punkte Unterschied merkt man im Alltag ohnehin kaum – die Speicherklasse entscheidet mehr als die Note.
Alles über 64 GB ist meistens kein Privatanwender-Terrain mehr: Das aktuelle Open-Weights-Frontier wie DeepSeek V4.1-Flash (552 Milliarden Parameter) läuft nur auf Enthusiasten-Setups wie zwei gekoppelten DGX-Spark-Rechnern mit zusammen 256 GB – und liefert dann 25 bis 41 Tokens pro Sekunde.
Kleine Helfer: Was unter 8 GB wirklich geht
Fürs Coden gibt es einen Klassiker, der immer noch gesetzt ist: Qwen2.5-Coder-1.5B (1,1 GB). Das Modell ist auf Autovervollständigung spezialisiert, läuft im Hintergrund moderner Entwicklungsumgebungen und reicht für einzelne Funktionen, kleine Refactorings und das Lesen von Stacktraces. Neuere Modelle haben es bisher nicht verdrängt.
Erwarte aber keinen Agenten, der ganze Projekte umbaut: Kein Modell unter etwa 6 GB wurde je auf den anspruchsvollen Coding-Benchmarks gemessen – das ist die ehrliche Qualitätsgrenze dieser Klasse.
Für Home Assistant entscheiden nicht Modellgröße, sondern niedrige Latenz und zuverlässiges Function Calling (das Modell muss Gerätebefehle als strukturierte Aktionen ausgeben). Der Sweet Spot liegt bei 3 bis 8B: 4B-Modelle laufen auf CPU oder N100-Mini-PC, 8B mit GPU. Phi-4-mini etwa hat nachgewiesenes Home-Assistant-Tool-Calling; die Qwen3-Klasse gilt in der Community als Favorit.
So findest du das passende Modell
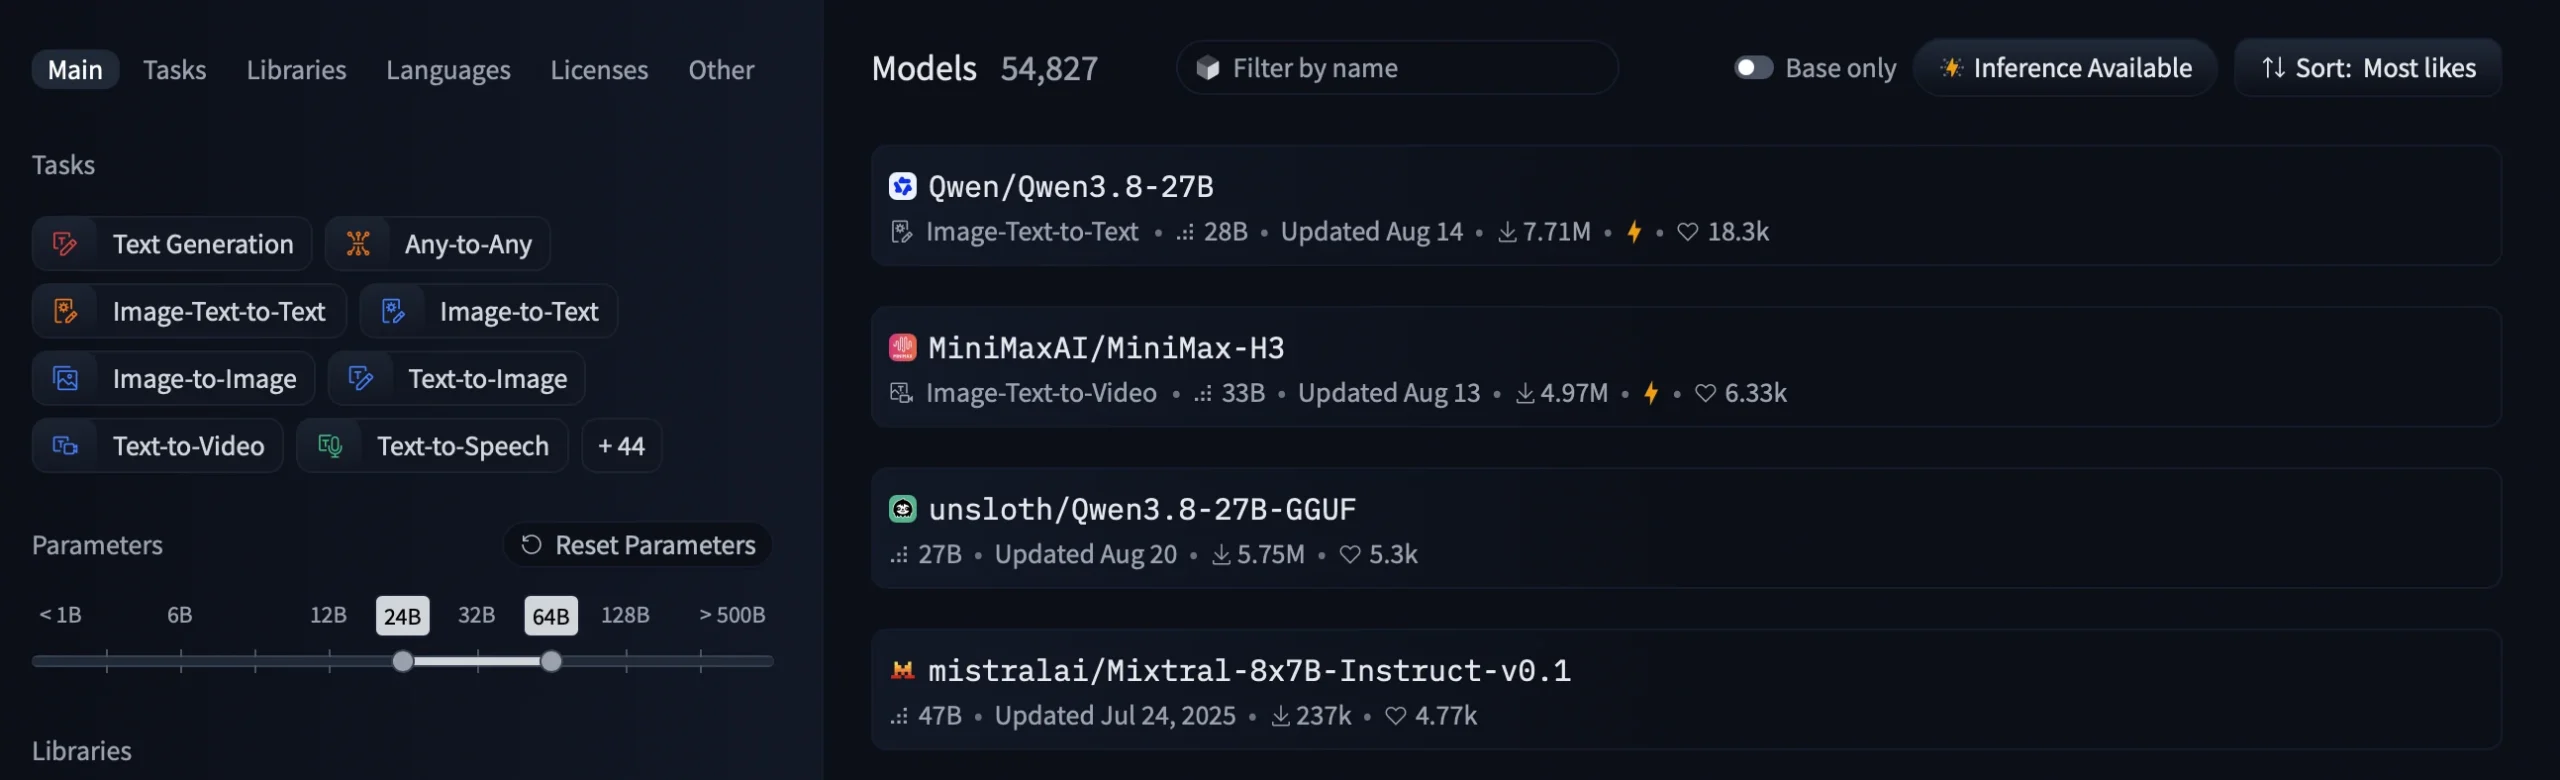
Die zentrale Anlaufstelle für offene Modelle ist Hugging Face. Dort lässt sich der Katalog nach Parameterzahl, Lizenz und Format filtern – etwa alle Modelle zwischen 24B und 64B, sortiert nach Trending. Stell den Bereich einfach auf deine Speicherklasse ein (etwa 1–8B für kleine Helfer). Wer direkt mit Ollama oder LM Studio starten will, filtert zusätzlich nach GGUF (Standardformat für lokale Tools) oder MLX (Apple).
Für den schnellen Qualitäts-Check: Die Seiten der Modelle enthalten meist Benchmark-Tabellen, oft mit direktem Vergleich zu anderen Modellen. Diese Angaben stammen aber in der Regel vom Hersteller selbst – ein guter erster Anhaltspunkt, kein neutrales Urteil.
Für unabhängige Vergleiche haben sich diese Quellen etabliert:
| Wenn du wissen willst … | dann schau … |
|---|---|
| … wie leistungsfähig ein Modell insgesamt ist | Artificial Analysis Intelligence Index: 10 standardisierte Tests, über 250 Modelle, unabhängig gemessen – inklusive Tempo und Preis |
| … was Nutzer bevorzugen | LMArena: Blind-Abstimmungen mit echten Nutzerstimmen |
| … ob es Function Calling beherrscht | Berkeley Function-Calling Leaderboard – wichtig etwa für Home Assistant |
| … wie gut es auf Deutsch ist | German-Aggregate-/INCLUDE-Benchmarks |
| … wie gut es beim Coden ist | SWE-bench Verified, LiveCodeBench, Aider |
Eine Einschränkung gehört dazu: Kein einzelner Test deckt alle Modelle ab. Der frühere Open LLM Leaderboard von Hugging Face ist inzwischen archiviert; heute brauchst du zwei bis drei Quellen. Und sei skeptisch: Werte werden teils selbst berichtet. Wenn du zwischen zwei Kandidaten schwankst: beide laden und mit deinen eigenen Aufgaben testen. Das schlägt jede Tabelle.
Sonderfall Deutsch: Soofi S
Soofi S zeigt, wie weit Europa bei offenen Modellen gekommen ist. Das 31,6B-MoE-Modell (nur rund 3,2B Parameter pro Token aktiv) stammt von einem Konsortium um KI Bundesverband, Fraunhofer und DFKI und wurde auf der Telekom-KI-Cloud in München trainiert – auf souveräner Infrastruktur, mit Deutsch als Schwerpunkt.
In deutschen Benchmarks erreicht es als bestes volloffenes Modell einen Aggregate-Wert von 85,3 und liegt bei deutschem Code vorn. Schwächen zeigen sich bei Faktenwissen (Folge der kleinen aktiven Parameterzahl), Wettbewerbsmathematik und Extraktion aus sehr langem Kontext. Die GGUF-Varianten liegen bei 26 GB (Q5), 33,6 GB (Q8) und 63,2 GB (unquantisiert); das offizielle Setup nutzt rund 8 GB VRAM mit Auslagerung auf eine 12-GB-Karte. Stand Ende 2026 ist Soofi S noch Beta – ein finaler offener Release ist angekündigt.
Für die Einordnung wichtig: Es gibt de facto kein zweites deutsches Open-Source-LLM und nur sehr wenige europäische Alternativen (etwa Mistral mit der Ministral-Reihe). Wer Datensouveränität als Argument für lokale KI anführt, sollte das wissen.
Grenzen, Kosten und die ehrliche Cloud-Frage
Lokale KI ist 2026 selten die günstigere Lösung. Ein 32-GB-DDR5-Kit kostete im April 2025 noch 70 Euro – im Oktober 2026 sind es 500 Euro. Die Speicherkrise trifft genau die Hardware, die lokale Modelle brauchen. Beim Mac mini* etwa kostet der Sprung von 16 auf 32 GB Speicher 440 Euro – ungefähr zwei Jahre eines typischen 20-Euro-KI-Abos. Und die Cloud-Modelle sind stärker.
| Cloud (GPT-6, Claude & Co.) | Lokal | |
|---|---|---|
| Qualität | aktuelles Frontier, rund 15 Punkte voraus | Vorjahres-Niveau |
| Kosten | Abo ab etwa 20 Euro/Monat | Hardware + Strom, 2026 teuer |
| Daten | verlassen den Rechner | bleiben bei dir |
| Offline | nein | ja |
| Limits | Nachrichtenlimits, Modellwechsel | keine Limits, stabile Version |
Die Entscheidung hängt deshalb weniger am Geld als am Zweck: Für Privatsphäre, Offline-Betrieb und Unabhängigkeit ist lokal unschlagbar. Wer dagegen das absolute Frontier braucht – komplexe Agenten, Top-Coding – bleibt in der Cloud. Und wer ohnehin nur gelegentlich chattet, fährt mit einem Abo meist einfacher.
Ehrlich dazugehört auch: Offene Modelle aktualisieren sich nicht von selbst. Sicherheit und Qualität bleiben in deiner Verantwortung – ein Argument für etablierte, gut gepflegte Modellfamilien.
So startest du
Der einfachste Weg ist Ollama: installieren, im Terminal ollama run aufrufen, fertig. Auf Apple-Silicon-Macs läuft seit 2026 die schnellere MLX-Engine (15 bis 25 Prozent mehr Tempo). LM Studio ist die grafische Alternative – sie zeigt schon vor dem Download, wie viel RAM oder VRAM ein Modell braucht, und eignet sich damit ideal für Einsteiger. llama.cpp ist die Engine unter beiden und die Wahl für alle, die maximale Kontrolle wollen.
Zwei Stolperfallen aus der Praxis: Ollama startet standardmäßig nur mit kurzem Kontext (4K) – für längere Texte musst du das erhöhen. Und die Modellnamen in der Ollama-Bibliothek weichen leicht von den Hugging-Face-Namen ab.
Als Startpunkt gilt: Nimm das größte Modell, das in deine Speicherklasse passt. Auf einem 16-GB-Mac ist Gemma 4 12B ein guter erster Download, mit 24 GB oder mehr greifst du direkt zu Qwen3.8-27B. Auf einem Heimserver kannst du Ollama dauerhaft laufen lassen und per Open WebUI (selbst gehostetes Chat-Interface) im Browser nutzen – passende Hardware findest du in den Empfehlungen für deinen günstigen Heimserver – passende Grafikkarte aber nicht vergessen!
Fazit: Dein Speicher entscheidet, nicht das Modell
Die wichtigste Erkenntnis zuerst: Lokale KI ist 2026 keine Frage des Modells, sondern des Speichers.
- Mit 24–32 GB bekommst du den Sweet Spot: Qwen3.8-27B und Co. erreichen das Niveau des Vorjahres-Flaggschiffs – rund 84 von 100 Punkten –, zum Preis der Hardware, aber ohne Abo und ohne Datenabfluss.
- Mit 8–16 GB sind solide kleine Allrounder drin.
- Unter 8 GB übernehmen kleine Spezialisten Autovervollständigung und Aufgaben wie Home Assistant.
- Das aktuelle Cloud-Frontier bleibt rund 15 Punkte voraus – für Agenten und Spitzen-Coding bleibt die Cloud die erste Wahl.
Wer vorhandene Hardware nutzt und Datensouveränität wichtig findet, kommt 2026 so nah an die Oberklasse wie nie. Alle Angaben: Stand Ende 2026.
Häufige Fragen
Reichen 16 GB RAM für lokale KI-Modelle?
Ja, für Modelle bis etwa 12B Parameter. Bei 27B wird es eng: Nur mit stärkerer Kompression (IQ4_XS) oder 3 Bit läuft es – komfortabel wird es erst ab 24 GB.
Kann lokale KI ChatGPT vollständig ersetzen?
Nein. Lokal bekommst du das Niveau des Vorjahres-Flaggschiffs. Für Agenten, Top-Coding und Spezialwissen bleiben die aktuellen Cloud-Modelle rund 15 Punkte voraus.
Welches Modell ist der beste Einstieg?
Das hängt vom Speicher ab: Mit 8 GB startest du mit K2 Horizon 7B, mit 16 GB mit Gemma 4 12B, mit 24 GB oder mehr direkt mit Qwen3.8-27B.
Ist lokale KI wirklich kostenlos?
Die Software ja, die Hardware nicht. 2026 sind RAM und Grafikkarten wegen der Speicherkrise teuer – lokal rechnet sich vor allem über Privatsphäre und Unabhängigkeit, nicht über den Preis.
Brauche ich eine NVIDIA-Grafikkarte?
Nein. Macs mit Unified Memory sind für viele die einfachste Lösung, kleine Modelle laufen sogar nur auf der CPU. Eine Grafikkarte mit 24 GB lohnt sich, wenn du die 27B-Klasse schnell betreiben willst.
Läuft ein LLM auf einem Mini-PC oder Raspberry Pi?
Bis etwa 4B Parameter ja – langsam, aber brauchbar für Autovervollständigung oder Home Assistant. Für 7B und mehr brauchst du Geduld oder eine GPU.
Wie erkenne ich, ob ein Modell gut ist?
Modellkarte auf Hugging Face als erster Blick, dann ein unabhängiger Vergleich über Artificial Analysis oder LMArena. Am Ende zählt der eigene Test mit deinen Aufgaben.
